Chuông PagerDuty trên điện thoại của bạn réo ầm ĩ. Toàn bộ hệ thống vừa bị nhà cung cấp LLM khóa API với lỗi HTTP 429. Hạn ngạch Token của cả tháng bị đốt sạch chỉ trong vòng 15 phút, trong khi lưu lượng mạng Tải lên (Upstream) vọt qua ngưỡng đỏ. Không có cuộc tấn công DDoS nào từ bên ngoài, thủ phạm lại chính là một cụm AI Agent tự trị của hệ thống đang bị kẹt trong vòng lặp vô tận và liên tục nã hàng triệu token vào backend.
Khi áp dụng các tư duy quản trị HTTP truyền thống vào môi trường AI, kỹ sư vận hành (Operations Engineer) thường rơi vào trạng thái bị hạn chế tầm nhìn vì không đo lường được ngữ nghĩa của dữ liệu. Một request trả về HTTP 200 hoàn toàn có thể là một vòng lặp suy luận vô nghĩa đang tiêu tốn hàng chục đô la. Đó là lý do việc triển khai một nền tảng giám sát lưu lượng Proxy Server chuyên biệt cho AI đang trở thành yêu cầu sống còn.
Làm thế nào để bóc tách chi phí token và ngắt mạch Agent kịp thời trước khi hóa đơn API vượt kiểm soát? Đâu là stack công nghệ hiện đại của năm 2026 để xử lý bài toán này mà không tạo thêm điểm nghẽn cho hệ thống? Hãy cùng bóc tách kiến trúc và các thủ thuật triển khai thực chiến ngay sau đây.
Tại sao Agent Swarm dễ dàng bóp nghẹt hạ tầng mạng của bạn?
Trước khi bắt tay vào cấu hình các công cụ quan sát, chúng ta cần phân tích cấu trúc traffic của AI Agent Swarm. Dòng dữ liệu này mang những đặc thù rất khác biệt so với giao tiếp client-server thông thường.
Đặc thù traffic: Burst Request và Streaming kéo dài
Ở các ứng dụng web thông thường, tương tác diễn ra tuyến tính và có thời gian nghỉ (think time) giữa các lượt truy cập. Ngược lại, một yêu cầu đầu vào từ người dùng có thể kích hoạt hàng chục request liên tiếp giữa các sub-agents (East-West traffic) hoạt động ở tốc độ máy.
Bên cạnh đó, các luồng phản hồi từ LLM phụ thuộc vào giao thức Streaming SSE (Server-Sent Events) để đẩy dữ liệu theo từng token. Điều này buộc hạ tầng mạng phải duy trì hàng ngàn kết nối mở trong thời gian dài (long-horizon sessions). Nếu các bộ đệm (ví dụ như proxy_buffering của Nginx) không được tắt hoặc tinh chỉnh cho luồng streaming, dữ liệu sẽ bị ngâm trong RAM, làm cạn kiệt bộ nhớ hệ thống một cách thầm lặng trước khi tiến trình OOM Killer kịp can thiệp.
Thảm họa Retry Storm và sự phình to của Context Window
Trong kiến trúc microservices, bão thử lại (Retry Storm) vốn đã tiềm ẩn rủi ro, nhưng với AI Agent, mức độ tàn phá được khuếch đại lên nhiều lần. Khi một HTTP request bình thường retry, nó chỉ gửi lại vài KB payload dạng JSON. Khi một AI Agent retry, nó gửi lại toàn bộ Context Window, bao gồm hệ thống prompt, tài liệu RAG, và chuỗi lịch sử trò chuyện dài hàng ngàn token.
Sự khác biệt về khối lượng này tạo ra các điểm nghẽn cục bộ trầm trọng:
- Vắt kiệt băng thông Upstream: Mạng HTTP truyền thống thường tải xuống nhiều hơn tải lên. Tuy nhiên, AI Agent đẩy tỷ lệ băng thông tải lên vọt mức 10-15%, chiếm dụng tài nguyên của card mạng do phải liên tục nhồi ngữ cảnh ngược về mô hình.
- Cháy hạn ngạch TPM: Các provider như OpenAI hay Anthropic giới hạn theo Tokens Per Minute (TPM). Một vài đợt agent retry mang theo 30.000 token/request sẽ làm cạn kiệt TPM, dẫn đến việc phải đối mặt với lỗi Rate Limit API trên toàn bộ tổ chức, khiến các dịch vụ khác bị vạ lây. Việc triển khai quản lý Proxy Pool cho AI Agent là bước đệm quan trọng để phân bổ lại hạn ngạch này.
- Sập bộ nhớ GPU KV-Cache: Khi ngữ cảnh khổng lồ đổ về, máy chủ GPU inference (như vLLM hoặc Triton) phải khởi tạo lại quá trình Prefill để dựng KV-Cache. Lượng request retry ồ ạt sẽ nhanh chóng làm tràn hàng chờ xử lý của các card đồ họa.
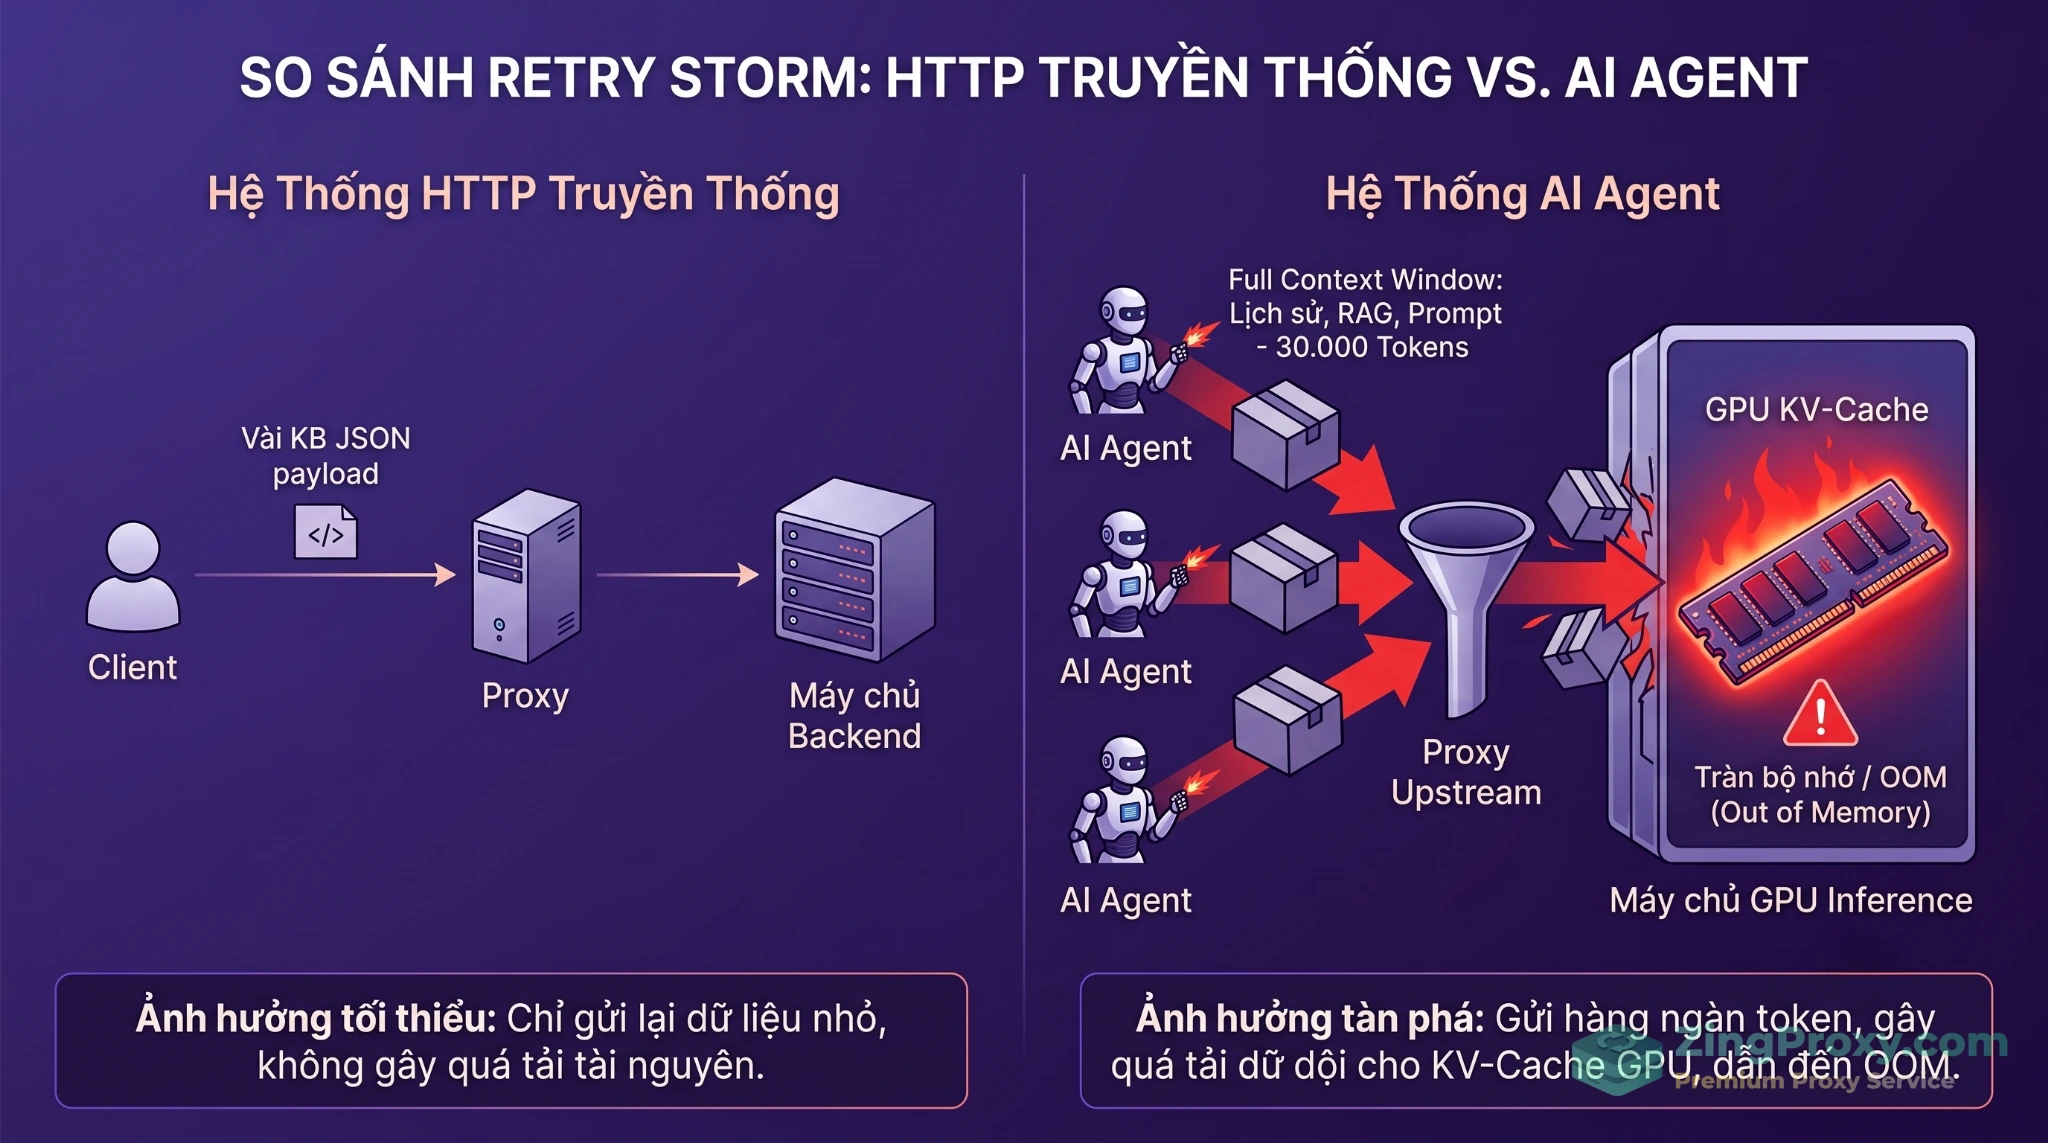
Minh họa sự khác biệt khối lượng dữ liệu giữa Retry HTTP truyền thống và Retry của AI Agent mang theo toàn bộ Context Window làm tràn GPU KV-Cache.
Kiến trúc giám sát lưu lượng Proxy Server hiện đại (không điểm nghẽn)
Để bắt mạch được hạ tầng AI mà không làm chậm tốc độ phản hồi, hệ thống giám sát cần sự kết hợp giữa các tiêu chuẩn viễn trắc mới và công nghệ can thiệp sâu từ lõi hệ điều hành. Các mô hình đặt một API Gateway cồng kềnh chắn ngang đường truyền đang dần bộc lộ nhược điểm về độ trễ.
Chuẩn hóa Telemetry với OpenTelemetry GenAI
Tính đến tháng 5 năm 2026, OpenTelemetry đã chính thức tốt nghiệp (graduated) khỏi CNCF và hoàn thiện bộ tiêu chuẩn Semantic Conventions cho Generative AI. Thay vì phụ thuộc vào các format metric mang tính cục bộ của từng công cụ (như LiteLLM hay Kong), hệ thống giờ đây sử dụng bộ từ vựng trung lập (vendor-neutral) gen_ai.*.
Việc ứng dụng chuẩn này mang lại sự linh hoạt. Kỹ sư hệ thống có thể thu thập các span và metric (như gen_ai.system.prompt, gen_ai.usage.input_tokens) và xuất ra bất kỳ backend nào (Prometheus, Datadog, New Relic) thông qua OTel Collector mà không yêu cầu viết lại mã nguồn khi thay đổi nền tảng.
Bí kíp thực chiến: Chống vỡ Dashboard khi cập nhật thư viện
Dù OpenTelemetry GenAI đã trở thành tiêu chuẩn, bộ từ vựng gen_ai.* vẫn đang ở trạng thái phát triển (Development). Tên các thuộc tính có thể bị thay đổi mà không cần cảnh báo.
Để an toàn, hãy luôn cấu hình biến môi trường OTEL_SEMCONV_STABILITY_OPT_IN=true hoặc khai báo alias. Biến này ép hệ thống xuất song song cả tên thuộc tính cũ và mới trong quá trình chuyển đổi, đảm bảo các Dashboard Grafana của bạn không bị mất dữ liệu đột ngột vào ngày đội ngũ phát triển quyết định nâng cấp thư viện.
Bắt mạch traffic bằng eBPF (AgentSight) thay vì AI Gateway
Thay vì dựng thêm một proxy Lớp 7 phức tạp, việc ứng dụng eBPF (cụ thể là framework mã nguồn mở AgentSight) mang đến cách tiếp cận instrumentation-free (không cần can thiệp mã nguồn ứng dụng).
eBPF hoạt động trực tiếp ở cấp độ kernel. Nó chặn bắt các hàm thư viện mã hóa (như OpenSSL/BoringSSL) để đọc luồng traffic LLM trước khi chúng được mã hóa TLS gửi ra ngoài. Phương pháp này giúp bóc tách chính xác số lượng token, độ trễ và payload mà chỉ tiêu tốn dưới 3% hiệu năng CPU. Bạn vừa có được dữ liệu giám sát sâu sắc (deep observability), vừa giữ nguyên được sơ đồ định tuyến mạng mượt mà, không tạo thêm một single point of failure (điểm nghẽn đơn lẻ) nào cho cụm Swarm.
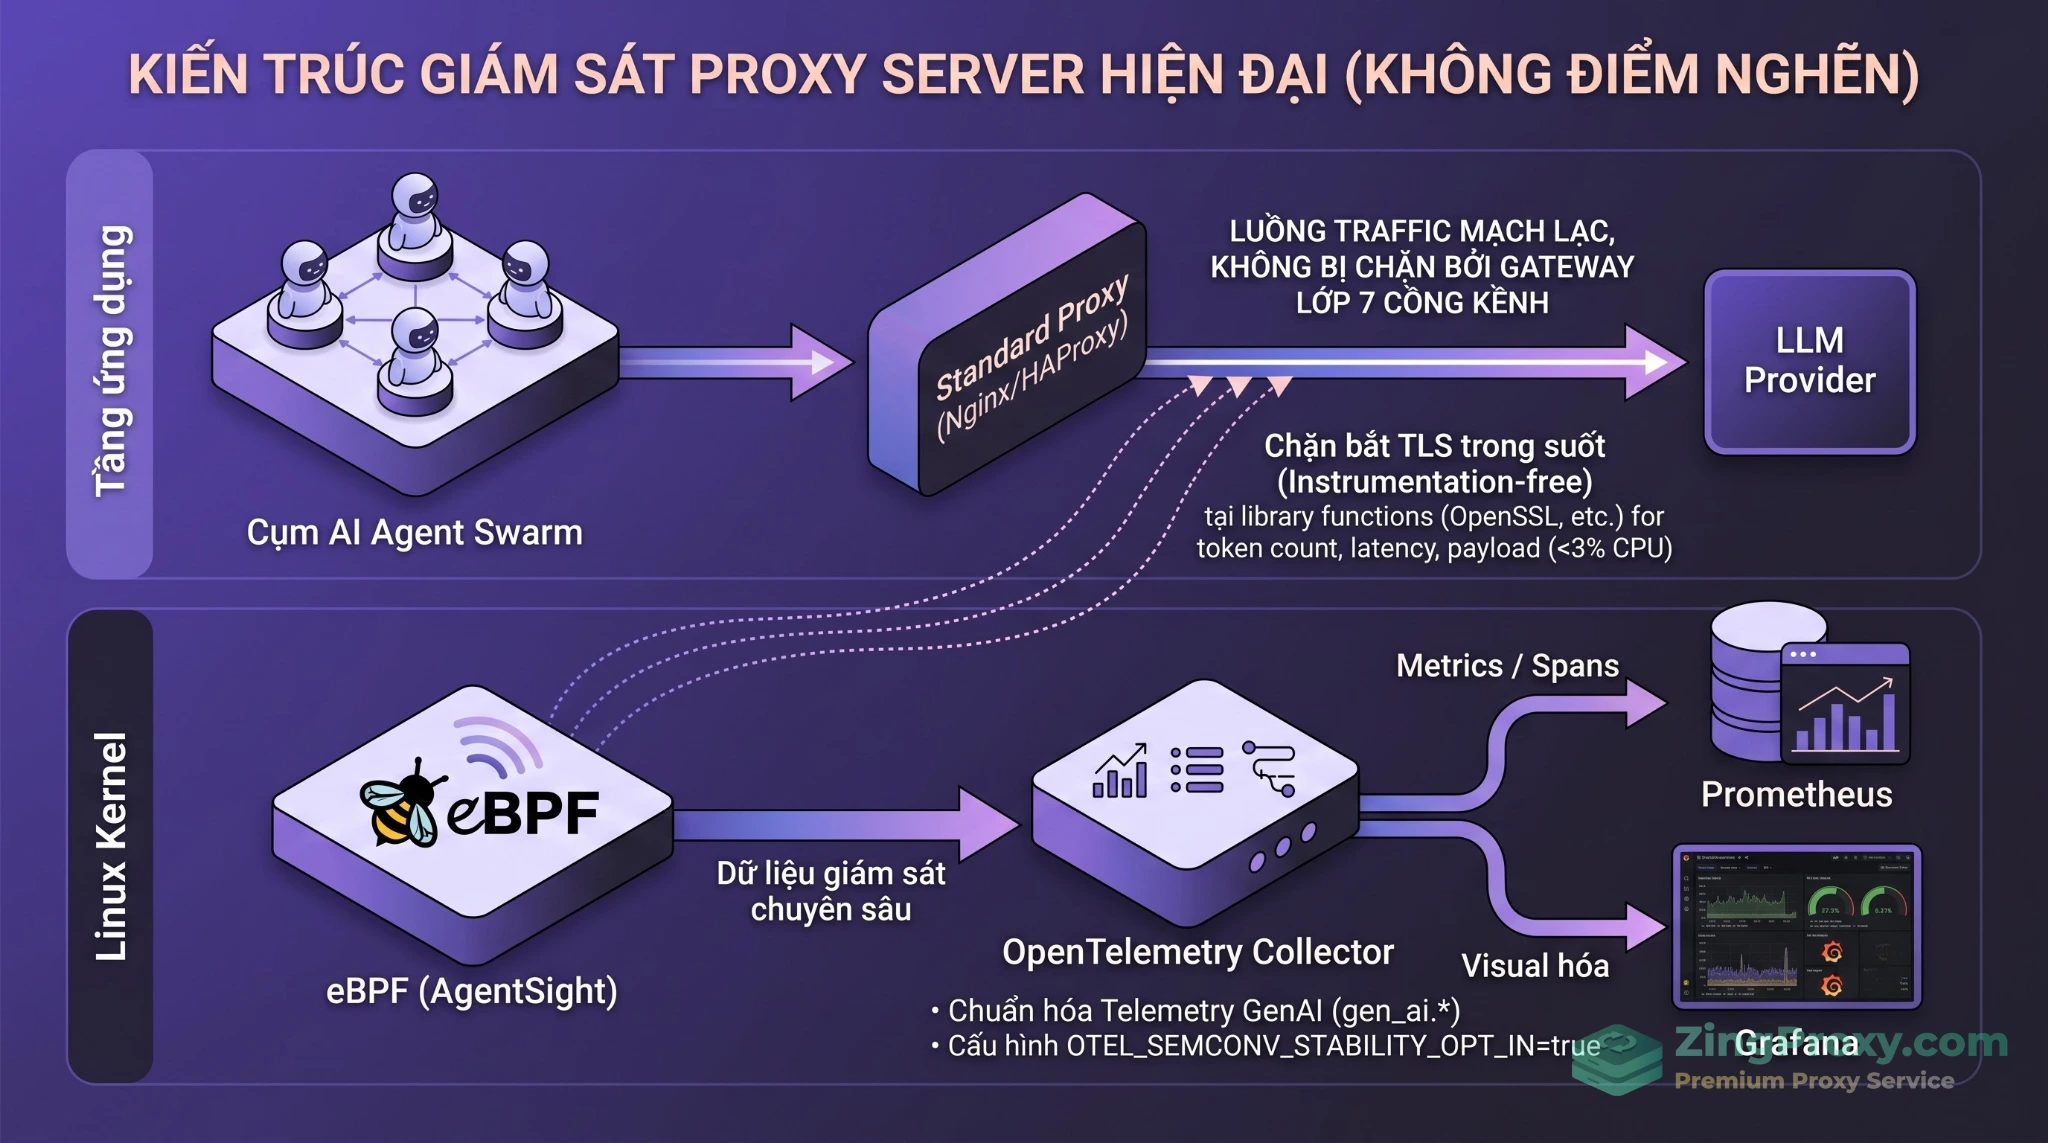
Kiến trúc trích xuất dữ liệu viễn trắc AI từ tầng Kernel bằng eBPF kết hợp chuẩn OpenTelemetry, loại bỏ hoàn toàn điểm nghẽn của API Gateway Lớp 7.
Xây dựng Grafana Dashboard: Từ HTTP thô đến hành vi Agent
Để thiết lập một hệ thống giám sát Proxy Grafana & Prometheus hiệu quả, bảng điều khiển (Dashboard) cần cung cấp góc nhìn đa lớp, từ các chỉ số TCP/HTTP cơ bản cho đến mức độ thông minh trong hành vi của Agent.
Nhóm RED Metrics (hạ tầng mạng)
Đây là các chỉ số giúp bạn nhận diện sức khỏe kết nối mạng ở mức thô, áp dụng tốt cho cả proxy truyền thống và proxy AI.
- Request Rate (Tốc độ Yêu cầu): Đo lường tải lượng request mỗi giây. Giúp bạn phát hiện ngay các đợt spike traffic.
- Error Rate (Tỷ lệ Lỗi 4xx/5xx): Báo hiệu khi Provider bắt đầu chặn truy cập (429) hoặc hệ thống backend gặp lỗi nội bộ (500/503).
- Latency P95 (Độ trễ toàn trình): Đo lường thời gian từ lúc Proxy nhận yêu cầu đến khi đóng luồng kết nối. Độ trễ P95 (bách phân vị 95) phản ánh trải nghiệm của nhóm người dùng gặp mạng chậm.
Nhóm Semantic Telemetry (ngữ nghĩa AI)
Nhờ chuẩn OTel GenAI và eBPF, chúng ta trích xuất được các thông số sinh tử của LLM mà log HTTP thông thường không thể thấy. Bạn có thể tham khảo thêm cách giám sát Traffic Proxy Server để hiểu sâu hơn về quy trình cấu hình.
- Time to First Token (TTFT): Thời gian phát token đầu tiên. TTFT P95 tăng vọt là tín hiệu rõ ràng cho thấy GPU KV-Cache đang chịu tải nặng ở khâu Prefill.
- Token Burn Rate: Đo lường tốc độ tiêu thụ token (Tokens/s). Đường biểu đồ này giúp đội Ops cảnh báo sớm nguy cơ chạm trần TPM trước khi lỗi 429 xuất hiện.
Nhóm Agent Behavior & Outcome (lớp metric nâng cao)
Nhiều hệ thống giám sát bỏ quên lớp metric trọng yếu này. Một Agent có thể trả về mã 200 OK, TTFT thấp, nhưng thực chất lại đang loay hoay gọi sai công cụ (tool calls) hoặc sinh ra nội dung ảo giác (hallucination).
- Steps per Task Histogram (Phân phối số bước/tác vụ): Biểu đồ này theo dõi số lượt Agent phải kích hoạt công cụ để hoàn thành một mục tiêu. Nếu số bước tập trung ở bách phân vị cao, Agent đang mắc kẹt trong một vòng lặp suy luận (reasoning loop) vô ích.
- Cost per Successful Task (Chi phí trên mỗi tác vụ thành công): Kết hợp tốc độ đốt token với tỷ lệ tác vụ hoàn tất để tính ra số tiền thực tế phải trả cho một kết quả có giá trị.
Để triển khai biểu đồ Cost per Successful Task, bạn có thể sử dụng khối lệnh PromQL thực chiến sau đây:
(
  sum(rate(agent_tokens_total{direction="input"}[1h])) * 3.00 / 1e6
  + sum(rate(agent_tokens_total{direction="output"}[1h])) * 15.00 / 1e6
)
/ sum(rate(agent_task_outcomes_total{outcome="success"}[1h]))
Mẹo nhỏ cho System Admin: Mức giá $3.00 (cho input) và $15.00 (cho output) trong công thức trên là ví dụ tính trên 1 triệu token. Trong môi trường production, một kỹ sư Ops dạn dày kinh nghiệm sẽ khai báo các mức giá này bên trong cấu hình Recording Rules của Prometheus thay vì gắn chết (hardcode) vào từng bảng hiển thị trên Grafana. Cách làm này giúp việc cập nhật bảng giá khi LLM Provider thay đổi chính sách trở nên gọn gàng, đồng bộ trên toàn hệ thống chỉ với một thao tác sửa file cấu hình.
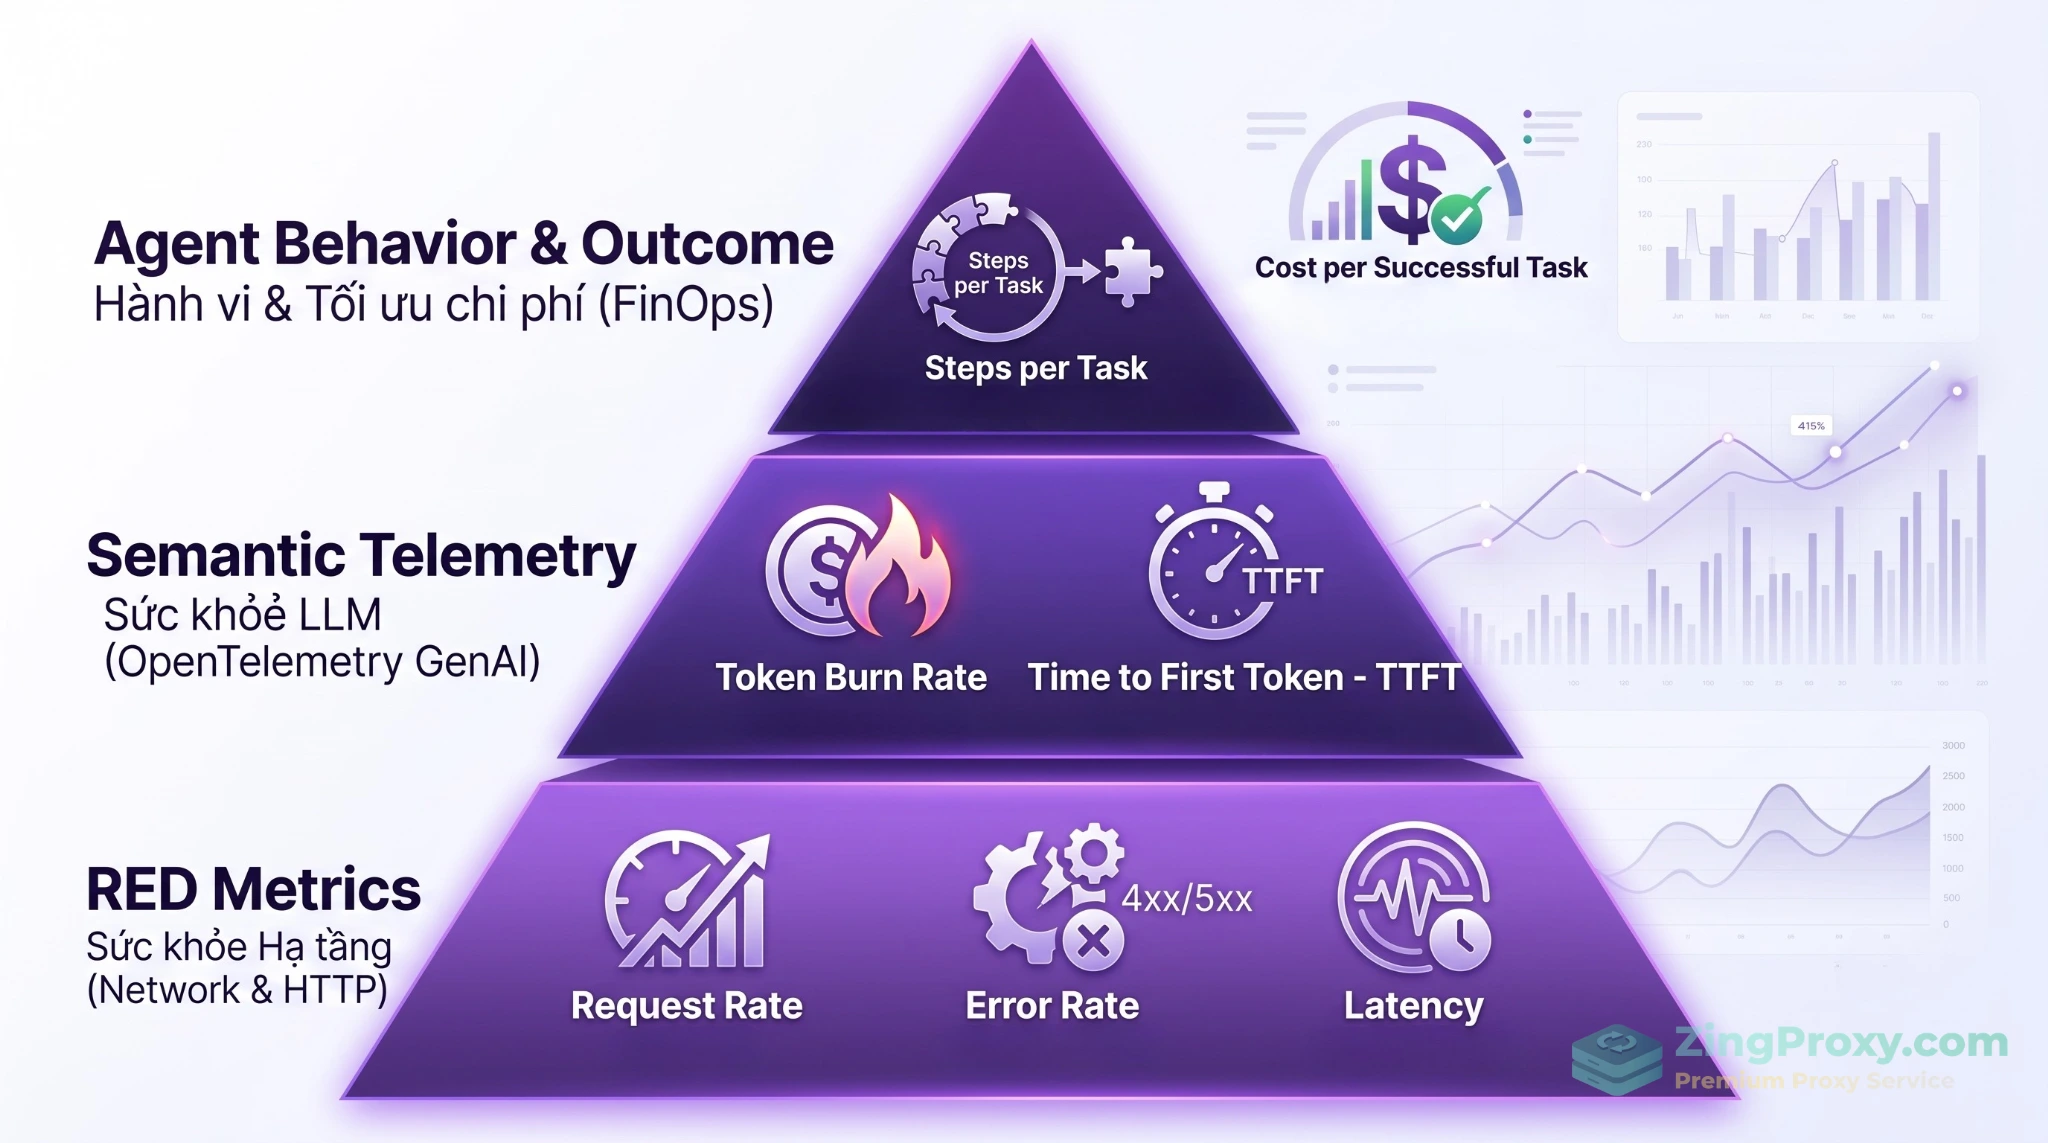
Mô hình 3 lớp chỉ số quan sát toàn diện AI Agent: từ sức khỏe hạ tầng mạng (TCP/HTTP) đến phân tích hành vi suy luận và chi phí thực tế (FinOps).
Tự động hóa cảnh báo dị thường với Grafana Framework
Với traffic AI có tính chất bùng nổ theo đợt (bursts), việc sử dụng các ngưỡng cảnh báo cố định (Fixed Thresholds), ví dụ như Token Rate > 5000/s, sẽ tạo ra vô số cảnh báo rác (false positives) vào các khung giờ hệ thống xử lý tác vụ hàng loạt. Mặt khác, việc tự viết các câu lệnh PromQL tính toán độ lệch chuẩn Z-Score thủ công lại phức tạp, dễ viết sai và cực kỳ khó bảo trì.
Khắc phục vấn đề này, framework promql-anomaly-detection của Grafana cung cấp các thuật toán cảnh báo bất thường trực tiếp trong Prometheus mà không cần dựng thêm server Machine Learning bên ngoài:
- Thuật toán Adaptive: Cấu hình này tự động học từ dữ liệu quá khứ (áp dụng bộ lọc làm mượt 26 giờ) để dự đoán đường cơ sở (baseline) của ngày hiện tại. Hệ thống sẽ tự động nới lỏng ngưỡng cảnh báo vào giờ cao điểm và siết chặt vào ban đêm.
- Thuật toán Robust (Sử dụng MAD): Dựa trên Độ lệch tuyệt đối trung vị (Median Absolute Deviation – MAD), thuật toán này có khả năng loại bỏ nhiễu từ các điểm dữ liệu dị biệt (outliers). Khi một Agent thỉnh thoảng tạo ra một request siêu lớn (ví dụ tải lên một file tài liệu khổng lồ), MAD sẽ không làm xô lệch toàn bộ đường cơ sở như cách tính trung bình cộng (mean) thông thường, giúp cảnh báo vận hành ổn định.
Để thấy rõ sức mạnh của framework này, dưới đây là một ví dụ thực chiến cấu hình Alertmanager bằng thuật toán Robust (MAD). Thay vì phải đoán một con số tĩnh cứng nhắc để làm ngưỡng, hệ thống sẽ đối chiếu dữ liệu thực với dải an toàn (Upper Bound) do thuật toán liên tục sinh ra:
groups:
  - name: agent_anomaly_alerts
    rules:
      - alert: AgentTokenBurnRateAnomaly
        expr: |
          # So sánh tốc độ đốt token thực tế với dải băng giới hạn trên (Upper Bound)
          # được tính toán liên tục bởi thuật toán robust (dùng trung vị và MAD)
          rate(gen_ai_usage_input_tokens[5m])
          >
          prometheus_model_upper_bound{anomaly_strategy="robust", metric_name="gen_ai_usage_input_tokens"}
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Phát hiện dị thường: Bùng nổ tiêu thụ Token (Thuật toán MAD)"
          description: "Tốc độ đốt token vượt dải băng dự đoán an toàn. Giá trị hiện tại: {{ $value }}. Có khả năng Agent đang kẹt vòng lặp suy luận."
Việc thiết lập cảnh báo dựa trên dị thường hành vi giúp đội ngũ vận hành ngủ ngon hơn, giảm thiểu hiện tượng alert fatigue (kiệt sức vì cảnh báo rác), và chỉ phải mở máy tính khi có sự cố ảnh hưởng trực tiếp đến trải nghiệm hoặc tài chính của tổ chức.
Tối ưu hạ tầng: Giải quyết triệt để cạn kiệt cổng (Ephemeral Port)
Giám sát lưu lượng Proxy Server phải đi kèm với năng lực tự bảo vệ hạ tầng. Khi dữ liệu giám sát chuyển sang màu đỏ, hệ thống cần tự động kích hoạt các cơ chế phòng vệ sau.
Kích hoạt Circuit Breaker mức ngữ nghĩa
Circuit Breaker (cầu dao ngắt mạch) là chốt chặn an toàn. Khi hệ thống giám sát phát hiện tỷ lệ lỗi (failure rate) hoặc số bước suy luận (steps per task) của một định danh Agent cụ thể vượt mức cho phép, Circuit Breaker sẽ chuyển từ trạng thái CLOSED sang OPEN.
Lúc này, Proxy sẽ chủ động từ chối các request tiếp theo mang theo Context Window cũ từ Agent đó. Hành động này ép Agent phải dừng lại hoặc khởi tạo một bộ nhớ ngữ cảnh hoàn toàn mới (Fresh Context) từ điểm khôi phục gần, giúp dập tắt bão token và ngăn chặn hiệu ứng sụp đổ dây chuyền (cascading failure) sang các khối Agent khác.
Tinh chỉnh Nginx giải quyết Ephemeral Port Exhaustion
Trong các cụm Swarm quy mô, hàng ngàn luồng Streaming SSE sẽ mở liên tục. Mỗi luồng này ngốn một cổng tạm thời (ephemeral port) của hệ điều hành. Định dạng của một kết nối TCP được xác định bởi 4 yếu tố (Source IP, Source Port, Destination IP, Destination Port). Khi proxy dùng 1 IP để kết nối ra ngoài, hệ điều hành Linux giới hạn khoảng hơn 60.000 cổng. Khi hết cổng, server sẽ từ chối dịch vụ với lỗi Cannot assign requested address.
Để mở rộng không gian cổng, kỹ sư hệ thống sử dụng kỹ thuật đa dạng hóa IP nguồn (Virtual Local IPs) kết hợp mô hình Reverse Proxy phân tải API trên Nginx. Thông qua module split_clients và chỉ thị proxy_bind, luồng traffic đi ra (outbound) sẽ được phân bổ đều qua nhiều địa chỉ IP nội bộ, nhân bản giới hạn kết nối TCP.
http {
    # Băm kết nối dựa trên IP/Port để chia đều ra các IP nguồn nội bộ
    split_clients "$remote_addr$remote_port" $local_source_ip {
        20% 10.0.0.210;
        20% 10.0.0.211;
        20% 10.0.0.212;
        20% 10.0.0.213;
        *   10.0.0.214;
    }

    server {
        location /ai-endpoints {
            proxy_pass http://backend_llm_cluster;
            proxy_bind $local_source_ip; # Ràng buộc socket với IP nguồn
            proxy_http_version 1.1;
            proxy_set_header Connection ""; # Kích hoạt keepalive
        }
    }
}
Bằng cách cấu hình 5 địa chỉ IP nội bộ cho quá trình proxy_bind, Nginx có thể nhân tổng số lượng kết nối TCP đồng thời khả dụng lên tới hơn 300.000 cổng. Phương pháp này kết hợp với sysctl tuning (như net.ipv4.tcp_tw_reuse) sẽ giải quyết triệt để tình trạng nghẽn cổ chai mạng tại lớp proxy, đảm bảo hệ thống chịu được tải bùng nổ.
Câu hỏi thường gặp (FAQ)
1. Tại sao AI Agent Swarm lại dễ làm sập hạ tầng mạng hơn ứng dụng web thông thường?
Ứng dụng web chủ yếu tải dữ liệu xuống. Ngược lại, AI Agent đẩy mạnh băng thông tải lên (Upstream) vì mỗi khi gặp lỗi và retry, chúng gửi lại toàn bộ cửa sổ ngữ cảnh (lịch sử, prompt, RAG) lên tới hàng chục ngàn token, làm cạn kiệt API Rate Limit và đánh sập GPU KV-Cache.
2. Công nghệ eBPF (AgentSight) có ưu điểm gì so với việc dùng AI Gateway Lớp 7?
eBPF chặn bắt và đọc luồng dữ liệu LLM trực tiếp từ lõi hệ điều hành (kernel) mà không cần sửa đổi mã nguồn ứng dụng. Việc này tiêu tốn dưới 3% hiệu năng CPU và không tạo thêm điểm nghẽn (bottleneck) trên đường truyền mạng.
3. Tại sao nên dùng thuật toán Robust (MAD) thay vì đặt ngưỡng tĩnh (Static Threshold)?
Đặt ngưỡng tĩnh dễ sinh ra báo động giả khi AI chạy các đợt request bùng nổ (burst). Thuật toán MAD tự động tính toán dải an toàn, lọc bỏ các điểm nhiễu (outliers) để hệ thống giám sát lưu lượng Proxy Server chỉ phát cảnh báo khi có sự cố thực sự.
4. Chỉ số Cost per Successful Task khác gì so với việc đếm Token thông thường?
Đếm Token chỉ cho biết bạn đã đốt bao nhiêu tài nguyên. Cost per Successful Task kết hợp dữ liệu token với tỷ lệ thành công của tác vụ, cho phép FinOps nhìn thấy chi phí thực tế phải trả để đổi lấy một kết quả có giá trị từ AI Agent.
5. Làm cách nào để xử lý triệt để lỗi cạn kiệt cổng (ephemeral port) trên Nginx?
Một IP tĩnh trên Linux bị giới hạn khoảng 60.000 cổng kết nối. Bạn cần dùng module split_clients và proxy_bind trên Nginx để phân bổ luồng traffic ra nhiều địa chỉ IP nội bộ (Virtual Local IPs), giúp nhân bản sức chứa kết nối TCP.
6. Biến môi trường OTEL_SEMCONV_STABILITY_OPT_IN có vai trò gì trong OpenTelemetry?
Ép hệ thống xuất song song cả tên thuộc tính cũ và mới trong giai đoạn chuẩn OTel GenAI đang phát triển, giúp các biểu đồ trên Grafana Dashboard không bị vỡ hoặc mất dữ liệu khi thư viện tự động cập nhật.
Kết luận
Việc xây dựng hệ thống giám sát lưu lượng Proxy Server cho AI Agent Swarm đòi hỏi kỹ sư vận hành phải cập nhật các tư duy mới. Bằng cách ứng dụng chuẩn OpenTelemetry GenAI, triển khai eBPF AgentSight để theo dõi sâu ở cấp độ kernel, và sử dụng các thuật toán cảnh báo dị thường từ Grafana, bạn hoàn toàn có thể đo lường chi phí thực tế, phát hiện các vòng lặp vô ích và bảo vệ GPU backend khỏi thảm họa Retry Storm.
Sự kết hợp giữa viễn trắc thông minh (semantic telemetry) và kỹ thuật cấu hình hạ tầng mạng sắc bén chính là chìa khóa để vận hành các hệ thống tự trị quy mô lớn một cách mượt mà, tối ưu ngân sách và đảm bảo tính ổn định vững chắc. Hệ thống của bạn đã sẵn sàng nâng cấp lên stack giám sát 2026 chưa? Hãy kiểm tra lại các bảng điều khiển và file cấu hình proxy của bạn ngay hôm nay!
Tài liệu tham khảo