Hệ thống crawler của bạn đang chạy mượt mà, bỗng nhiên log báo về hàng loạt mã lỗi HTTP 403. Hoặc vấn đề phức tạp hơn, trang web vẫn trả về mã 200 OK nhưng dữ liệu giá lại hoàn toàn sai lệch so với thực tế. Cùng lúc đó, server của bạn đang quá tải vì cạn kiệt RAM do phải duy trì hàng trăm session Playwright nặng nề. Đây là tình huống quen thuộc của các kỹ sư dữ liệu và nhà bán hàng khi cố gắng scale hệ thống theo dõi giá đối thủ trên các sàn thương mại điện tử quy mô rộng.
Khi bạn gửi hàng nghìn request từ một địa chỉ IP Datacenter cố định hoặc quản lý fingerprint không đồng bộ, việc bị hệ thống bảo mật đưa vào danh sách lọc chỉ là vấn đề thời gian. Để giải quyết bài toán định tuyến IP và xử lý rào cản địa lý (Geo-blocking), việc tích hợp Proxy dân cư Dropshipping vào pipeline thu thập dữ liệu là một bước chuyển đổi hạ tầng thiết yếu.
Vậy làm thế nào để rũ bỏ gánh nặng bảo trì hạ tầng cũ, xây dựng một luồng thu thập dữ liệu giá ổn định, tiết kiệm băng thông và tận dụng sức mạnh của AI? Khám phá ngay các khía cạnh kỹ thuật chuyên sâu trong bài viết này.
Vì sao crawler truyền thống liên tục bị chặn khi theo dõi giá đối thủ?
Các nền tảng thương mại điện tử hiện đại đầu tư ngân sách lớn cho các giải pháp Web Application Firewall (WAF) như Cloudflare, DataDome hay HUMAN Security. Mục tiêu của họ là bảo vệ luồng dữ liệu công khai và hạn chế việc server bị quá tải bởi các luồng truy vấn tự động.
Bẫy Rate-limit và Soft block từ các sàn TMĐT
Khi thu thập dữ liệu với cường độ cao bằng các công cụ truyền thống, hệ thống của bạn thường đối mặt với hai cấp độ phòng vệ cơ bản:
1. Hard Block (Chặn trực diện với mã lỗi HTTP 429 và HTTP 403)
- HTTP 429 (Too Many Requests): Cơ chế Rate Limiting được kích hoạt khi server nhận thấy một địa chỉ IP hoặc một session gửi quá nhiều request vượt ngưỡng cho phép trong một khung thời gian ngắn. Máy chủ sẽ từ chối xử lý và trả về header
Retry-After, yêu cầu client phải tạm dừng (cooldown) trước khi thử lại.
- HTTP 403 (Forbidden): Request của bạn bị từ chối truy cập hoàn toàn. Nguyên nhân thường xuất phát từ việc IP nằm trong dải Datacenter bị đánh dấu hạn chế, hoặc dấu vân tay trình duyệt (Browser Fingerprint) như TLS, WebGL, Canvas có điểm dị thường.
2. Soft Block (Chặn ngầm, Sát thủ thầm lặng của dữ liệu)
Khác với Hard Block, Soft Block mang lại nhiều thách thức hơn vì máy chủ vẫn trả về mã HTTP 200 OK. Tuy nhiên, nội dung HTML thực tế đã bị tráo đổi thành một trang thử thách CAPTCHA, một trang rỗng, hoặc âm thầm trả về dữ liệu giá giả lập (honeypot data).
Nếu scraper của developer chỉ kiểm tra mã trạng thái HTTP, hệ thống sẽ ngộ nhận là đã thành công và tiến hành ghi trực tiếp các dữ liệu lỗi này vào database. Điều này làm hỏng toàn bộ logic định giá tự động (Dynamic Repricing), khiến luồng vận hành đưa ra quyết định sai lầm và lãng phí lượng lớn tài nguyên phần cứng để tải những trang không có giá trị thực tế.
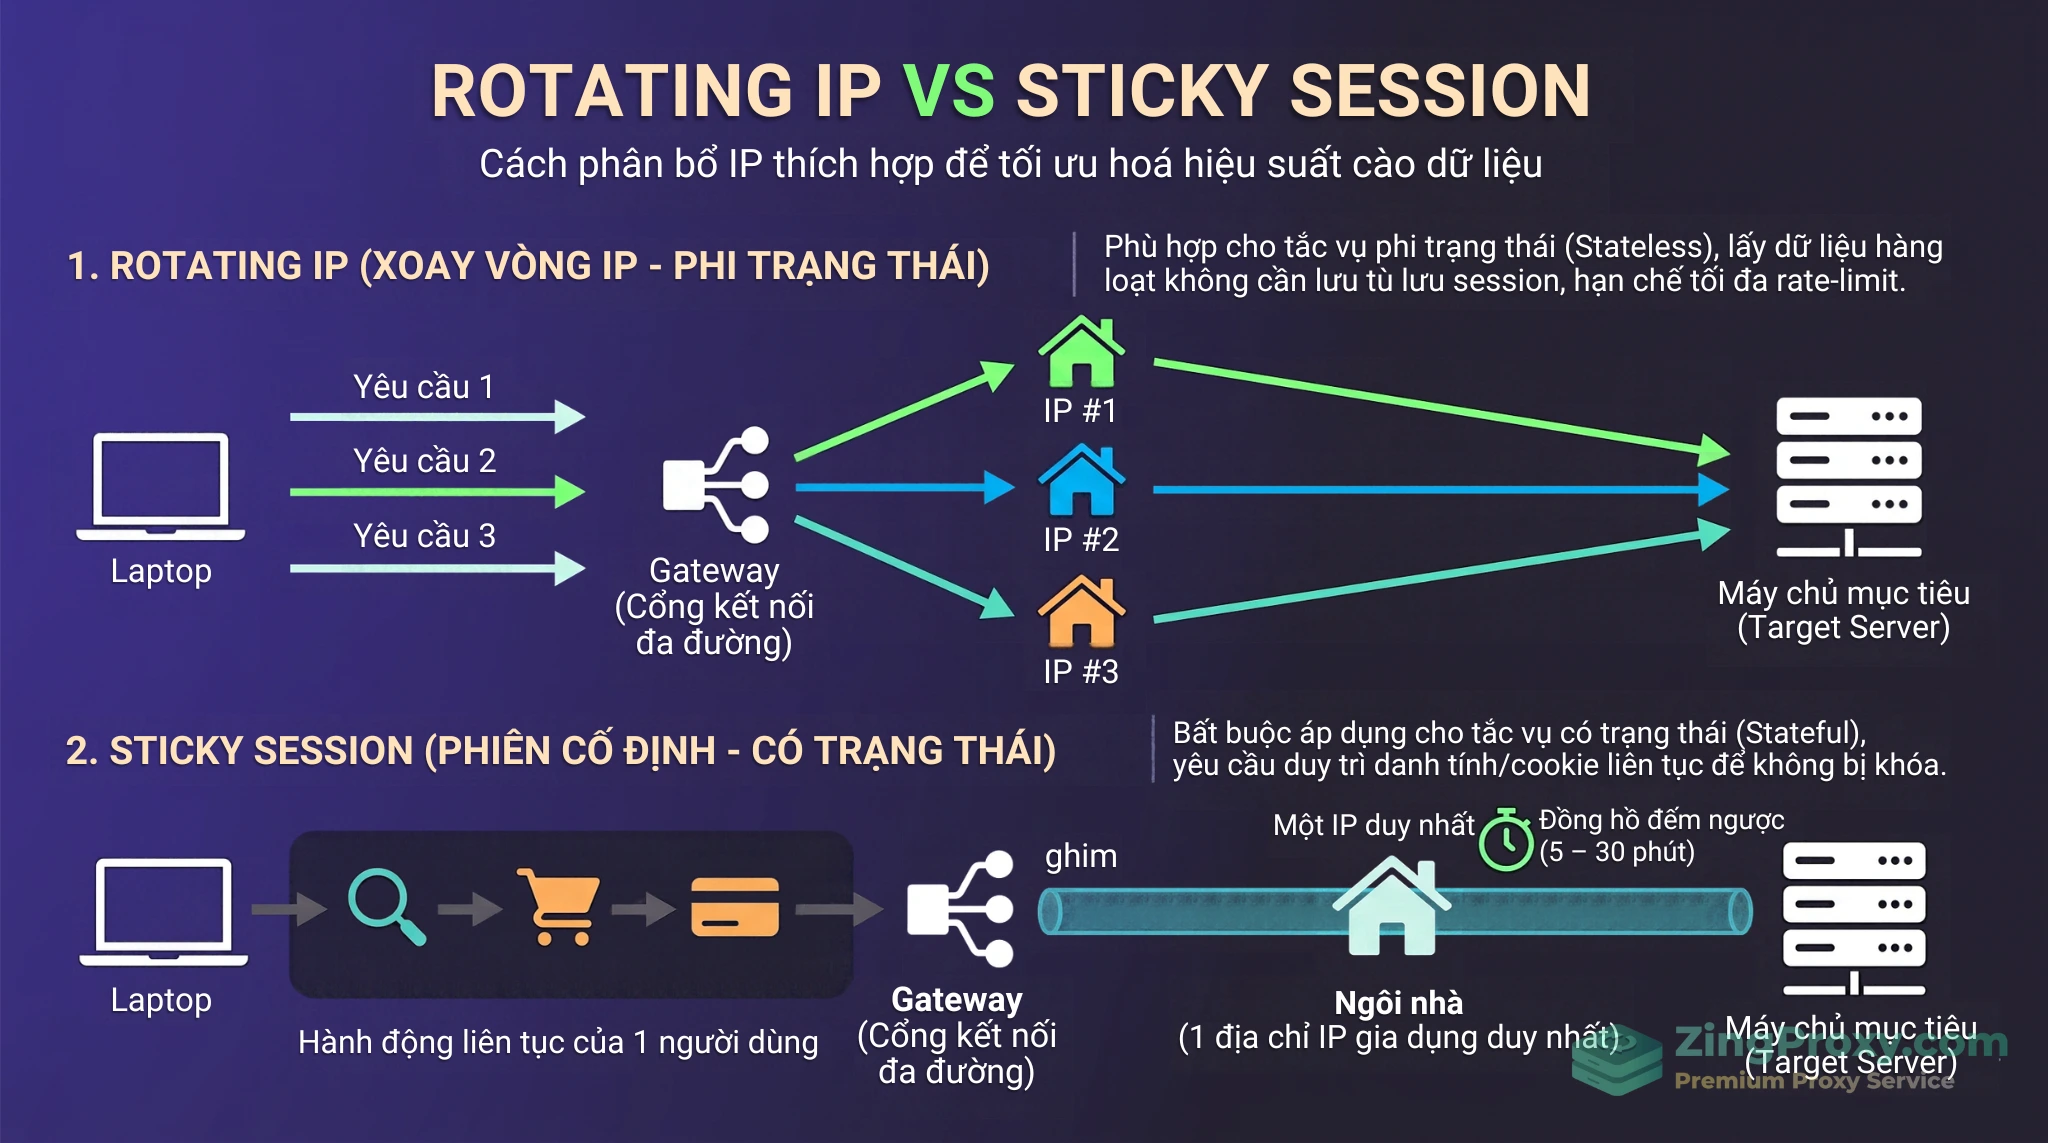
Cơ chế nhận diện và phản hồi của WAF: Hard Block (trả thẳng mã lỗi) so với Soft Block (đánh lừa bằng mã 200 OK và dữ liệu mô phỏng).
Bài toán Landed Price và rào cản địa lý
Nhiều kỹ sư gặp tình trạng: code chạy trên server ở Việt Nam hoặc Mỹ thu về một giá, nhưng khách hàng ở Đức hay Anh lại thấy một giá hoàn toàn khác. Đó là bài toán của Landed Price (Giá cập bến).
Công thức thực tế của định giá e-commerce:
Landed Price = Giá niêm yết - Chiết khấu + Phí vận chuyển + Thuế địa phương
Các nền tảng TMĐT sử dụng Geo-IP để xác định vị trí của khách hàng ngay khi kết nối:
- Phí vận chuyển: Được tính toán dựa trên khoảng cách từ kho xử lý đơn hàng đến vị trí IP của người dùng. Một IP nội địa có thể thấy trạng thái Freeship, trong khi IP quốc tế sẽ hiển thị cước phí cao hoặc báo không hỗ trợ giao hàng.
- Thuế địa phương (Local Taxes): Tại thị trường châu Âu, giá hiển thị thường đã bao gồm VAT. Tại Mỹ, giá niêm yết là trước thuế, và Sales Tax chỉ được cộng vào dựa trên vị trí IP theo từng bang hoặc hạt (county).
- Định giá động theo vùng (Dynamic Pricing): Cùng một mã SKU nhưng giá bán ở khu vực bờ Đông nước Mỹ có thể chênh lệch so với khu vực bờ Tây tùy thuộc vào tồn kho cục bộ.
Nếu hệ thống thu thập dữ liệu thị trường Anh bằng một địa chỉ IP tại Việt Nam, dữ liệu trả về sẽ không phản ánh đúng thực tế người dùng địa phương nhìn thấy.
Giải quyết rào cản định tuyến bằng hệ sinh thái Proxy
Để đáp ứng các tiêu chuẩn bảo mật khắt khe và lấy được dữ liệu Landed Price chuẩn xác theo từng khu vực, việc thiết kế lại hạ tầng mạng là yêu cầu bắt buộc.
Khác biệt cốt lõi của Proxy dân cư Dropshipping so với Datacenter
Sự chênh lệch về tỷ lệ request thành công giữa hai loại proxy nằm ở định danh mạng ASN (Autonomous System Number):
- Datacenter Proxy: Hoạt động trên các ASN thương mại (như AWS, DigitalOcean, Hetzner). Các WAF dễ dàng nhận diện và lọc hàng loạt các dải IP này (CIDR blocks) vì người dùng thông thường hiếm khi lướt web từ một máy chủ đám mây.
- Proxy dân cư Dropshipping (Residential Proxy): Được đăng ký trực tiếp dưới các nhà mạng viễn thông gia dụng (Consumer ISPs như Comcast, AT&T, Vodafone). Request của bạn được định tuyến qua các thiết bị kết nối mạng cáp quang hoặc Wi-Fi gia đình. Đối với WAF, lưu lượng này có độ tin cậy cao vì nó mang đặc điểm của một người dùng thực tế. Việc WAF hạn chế dải IP này sẽ mang lại rủi ro từ chối nhầm khách hàng thật của hệ thống.
Mở rộng: ISP Proxies (Static) và Mobile Proxies
Hệ sinh thái hạ tầng mạng hiện tại không chỉ dừng lại ở hai thái cực Datacenter và Residential. Các bài toán đặc thù yêu cầu những giải pháp chuyên biệt:
- ISP Proxies (Static Residential): Đây là các máy chủ vật lý đặt tại trung tâm dữ liệu nhưng địa chỉ IP lại được đăng ký dưới danh nghĩa nhà mạng viễn thông gia dụng. Phân khúc này mang lại tốc độ mạng cao của Datacenter nhưng lại có độ trust của IP dân cư. Điểm ưu việt là chúng thường được tính phí cố định theo IP thay vì dung lượng băng thông (GB), phù hợp cho các luồng công việc cần duy trì trạng thái dài hạn mà không lo đội chi phí.
- Mobile Proxies (Proxy di động): Sử dụng IP từ các trạm phát sóng mạng di động 4G/5G. Đặc thù của kiến trúc mạng di động (CGNAT) là hàng ngàn người dùng thật thường xuyên chia sẻ chung một địa chỉ IP. Các hệ thống WAF thường thiết lập cơ chế nới lỏng với dải IP này vì việc hạn chế một IP 4G có thể vô tình khóa truy cập của hàng trăm thiết bị di động khác.
Rotating vs Sticky Session: Ứng dụng thực tiễn
Thiết lập cơ chế phân bổ IP đúng cách quyết định hiệu suất của toàn bộ pipeline dữ liệu. Tùy thuộc vào bản chất của request, cổng Gateway trung gian cần được cấu hình theo hai chế độ cơ bản:
1. Rotating IP (Xoay vòng IP theo từng request)
- Cơ chế: Mỗi HTTP request được gửi đi sẽ tự động nhận một địa chỉ IP thoát hoàn toàn mới từ pool IP của nhà cung cấp.
- Mục đích: Tối ưu cho các tác vụ phi trạng thái (Stateless) như kiểm tra hàng loạt trang danh mục (Category), lấy kết quả tìm kiếm (SERP), hoặc check giá hàng nghìn SKU độc lập. Việc xoay IP liên tục giúp phân tán tải, giảm thiểu nguy cơ chạm ngưỡng Rate-limit trên bất kỳ địa chỉ IP đơn lẻ nào.
2. Sticky Session (Phiên cố định)
- Cơ chế: Ghim toàn bộ lưu lượng của client vào một địa chỉ IP cố định trong một khoảng thời gian xác định (thường từ 5 đến 30 phút). Cơ chế này được quản lý thông qua việc gắn thêm Session ID vào cấu hình username (ví dụ:
user-country-us-session-abc123).
- Mục đích: Áp dụng cho các luồng có trạng thái (Stateful) như đi qua phân trang sâu có liên kết cookie, kiểm tra giỏ hàng, nhập mã bưu chính (ZIP code) và ước tính phí ship. Nếu IP thay đổi đột ngột khi hệ thống đang điều hướng từ trang sản phẩm sang trang thanh toán, WAF sẽ ghi nhận đây là hành vi chiếm quyền phiên (session hijacking) và từ chối xử lý ngay lập tức.
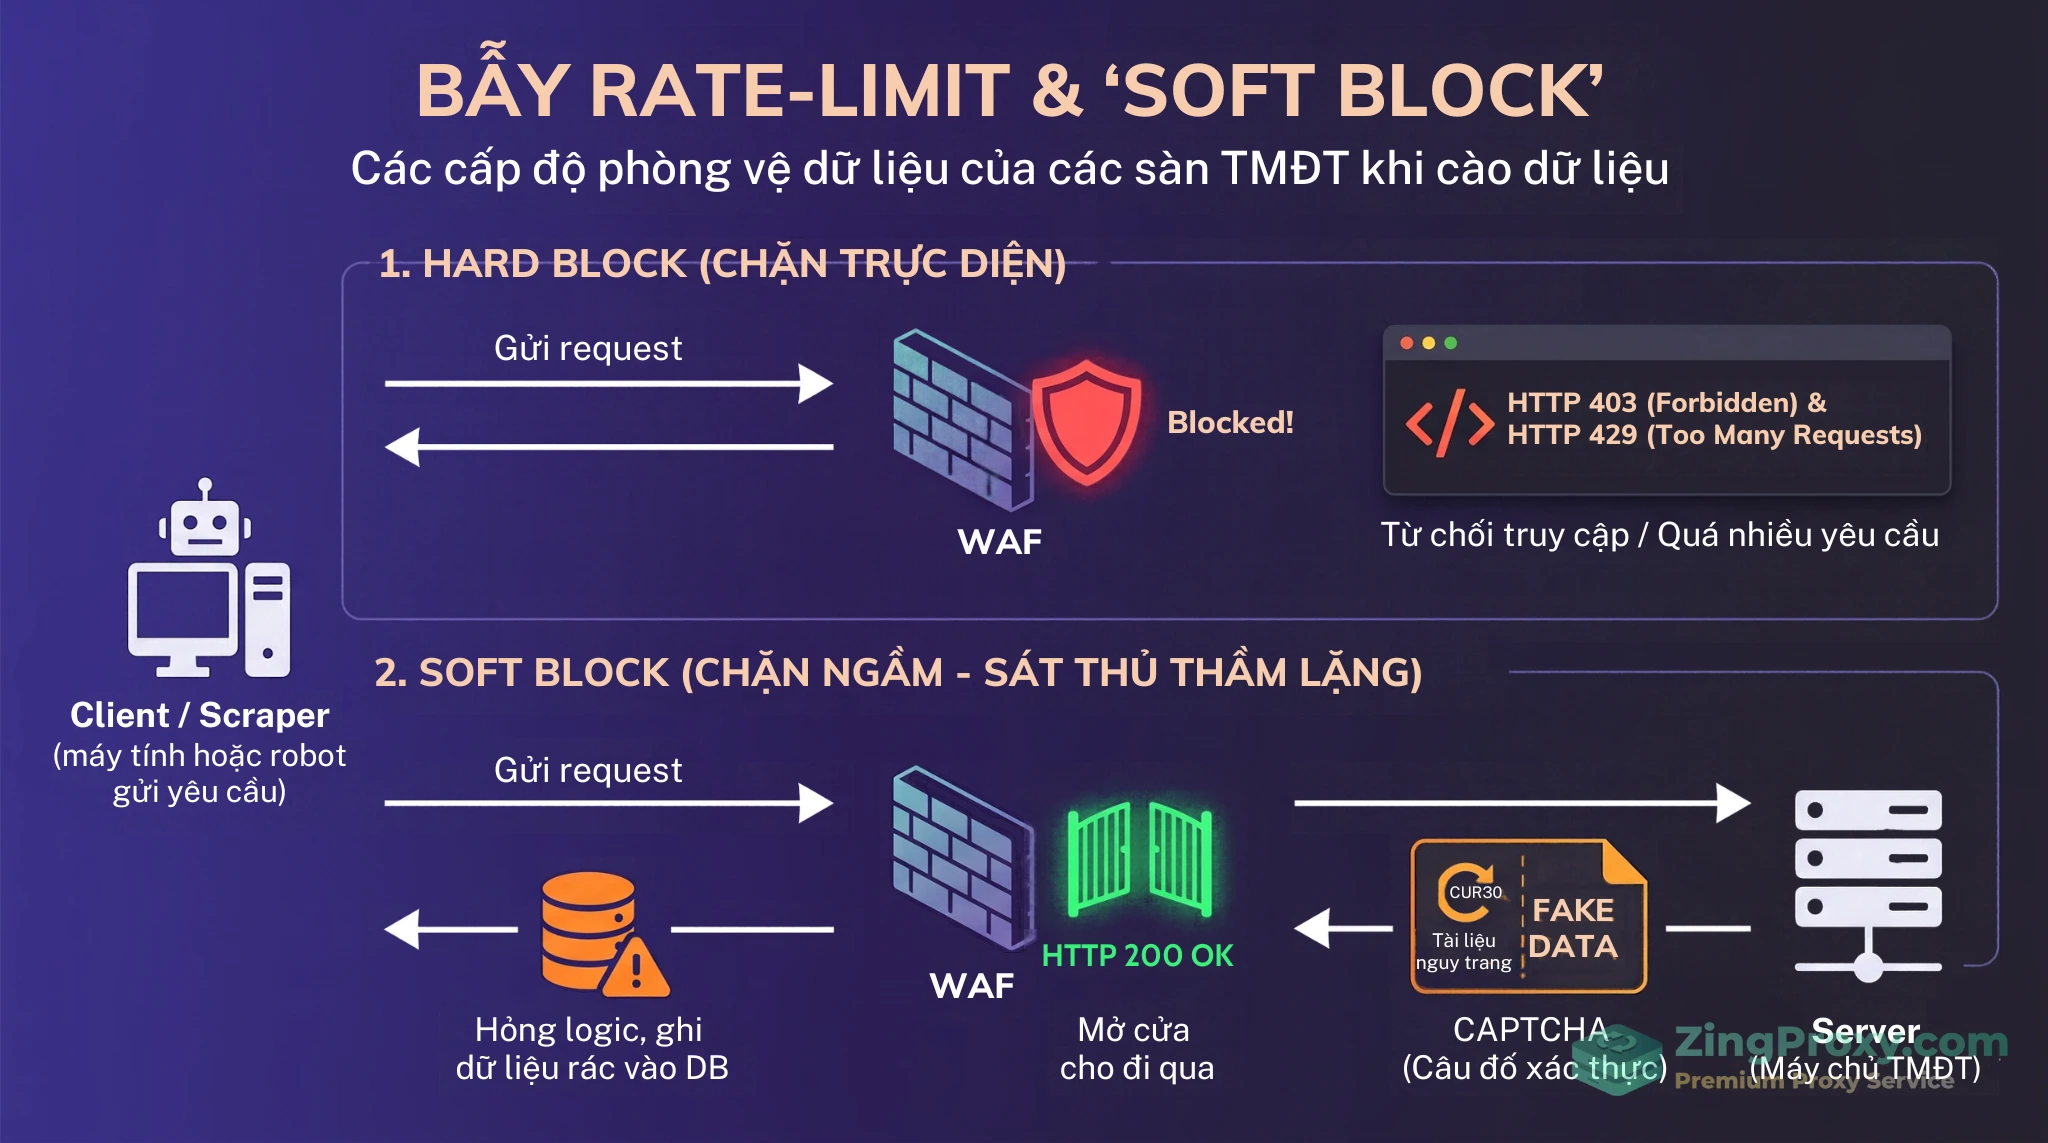
Phân bổ lưu lượng mạng: Xoay vòng IP cho các luồng truy vấn độc lập và Ghim phiên cố định cho chuỗi thao tác liên tục.
Thiết kế pipeline thu thập dữ liệu thế hệ mới
Trong quá khứ, các kỹ sư thường phải tự dựng kịch bản trình duyệt ảo bằng Playwright, Puppeteer hoặc Selenium. Việc tự quản lý hàng trăm browser context, cấu hình User-Agent, xử lý WebRTC leak và loay hoay giải CAPTCHA tiêu tốn nhiều tài nguyên máy chủ (CPU/RAM) và chi phí bảo trì nhân sự. Thế hệ pipeline hiện tại đã chuyển dịch mạnh mẽ sang các kỹ thuật tầng mạng và mô hình AI.
Xử lý WAF tầng mạng với TLS Fingerprinting
Một trong những lý do request bị Cloudflare chặn không phải do địa chỉ IP, mà do Client Hello ở tầng TLS/SSL. Khi sử dụng các thư viện như requests (Python) hoặc axios (Node.js), dấu vân tay mạng (JA3/JA4 fingerprint) sẽ khai báo rõ đây là một đoạn script tự động, khác với cấu trúc mã hóa của trình duyệt Chrome hoặc Safari thực tế.
Thay vì phải bật Playwright nặng nề chỉ để tương thích bước kiểm tra TLS, các kỹ sư hệ thống bắt đầu ứng dụng các HTTP client chuyên dụng như curl_cffi hoặc tls-client.
Các thư viện này mô phỏng quá trình bắt tay (handshake) của trình duyệt Chrome ở tầng mạng thấp. Khi kết hợp curl_cffi với mạng lưới Proxy dân cư Dropshipping, request của bạn trông hoàn toàn hợp lệ trong mắt WAF, cho phép tải mã HTML thô với tốc độ cao, tiêu tốn chưa đến 1/10 lượng RAM so với Headless Browser.
Chuyển dịch hạ tầng sang Managed Crawling APIs
Nếu việc duy trì thư viện TLS Fingerprint hoặc xử lý IP Pool vẫn là gánh nặng vận hành, giải pháp tối ưu hiện nay là ủy thác toàn bộ tầng xử lý tương thích WAF cho các hệ thống Managed Crawling APIs (như Crawlbase, WebScraping.AI, hay ScrapingBee).
- Nguyên lý hoạt động: Bạn chỉ cần gửi một HTTP GET request chứa URL đích đến API endpoint của nhà cung cấp giải pháp.
- Giá trị mang lại: Hệ thống API sẽ tự động đảm nhận việc định tuyến qua mạng lưới IP dân cư hoặc IP tĩnh, tự động xoay IP khi gặp lỗi, đồng bộ hóa Browser Fingerprint (khớp múi giờ, locale, header với vị trí Geo-IP mong muốn), và xử lý mượt mà các trang CAPTCHA. Cuối cùng, API trả về cho bạn mã HTML hoàn chỉnh.
- Tối ưu nguồn lực: Developer không còn phải viết code xử lý logic backoff (exponential backoff) phức tạp. Toàn bộ worker trở nên nhẹ nhàng, dễ dàng scale lên hàng chục nghìn concurrency bằng các HTTP client cơ bản.
AI-Powered Schema Extraction kết hợp LLMs
Hạn chế của kỹ thuật scraping truyền thống là sự phụ thuộc cứng nhắc vào XPath và CSS Selectors. Khi nền tảng TMĐT cập nhật giao diện, đổi tên class thẻ HTML (obfuscated class names) phục vụ A/B testing, toàn bộ parser của bạn sẽ gặp lỗi.
Để giải quyết triệt để vấn đề bảo trì code, kiến trúc hệ thống hiện đại đã ứng dụng AI-Powered Schema Extraction. Các framework như Crawl4AI kết hợp với Mô hình ngôn ngữ lớn (LLMs như OpenAI GPT-4o-mini, Gemma, Llama) mang lại khả năng đọc hiểu giao diện thông minh.
- Định nghĩa Schema thay vì viết code bóc tách: Thay vì tìm kiếm thẻ
div.price-tag, kỹ sư chỉ cần định nghĩa một cấu trúc dữ liệu JSON mong muốn (ví dụ: cần lấy product_name, landed_price_usd, stock_status, shipping_fee_estimate).
- Trích xuất bằng ngữ nghĩa: LLM sẽ tiếp nhận chuỗi HTML thô hoặc định dạng Markdown được chuyển đổi từ trang web. Dựa trên khả năng hiểu ngữ nghĩa, AI tự động xác định các thông số thị trường mà không cần quan tâm đến cấu trúc phân tầng của thẻ HTML.
- Sự bền bỉ trong vận hành: Ngay cả khi nền tảng thay đổi hoàn toàn giao diện website, mô hình AI vẫn có khả năng đọc và trả về đúng file JSON theo định dạng đã thiết lập, giảm thiểu tối đa rủi ro gián đoạn luồng dữ liệu.
Chiến lược giảm tải: Chỉ render khi thực sự cần thiết
Chi phí Proxy dân cư thường được tính theo dung lượng truyền tải thực tế ($/GB). Nếu bạn trích xuất toàn bộ hàng trăm ngàn sản phẩm mỗi ngày và tải full HTML, CSS, hình ảnh, hóa đơn hạ tầng mạng cuối tháng sẽ tạo ra áp lực tài chính lớn.
Khai thác Internal JSON APIs qua tab Network
Một nguyên tắc của giới kỹ sư dữ liệu là: Chỉ dùng trình duyệt ảo khi bắt buộc (Render Headless Only When You Have To). Dù Managed APIs hay AI rất mạnh, việc render toàn bộ JavaScript của một trang e-commerce vẫn tiêu tốn tài nguyên và băng thông.
Trước khi quyết định thu thập HTML, hãy mở trình duyệt, bật DevTools (F12) và chuyển sang tab Network (Fetch/XHR). Các nền tảng TMĐT hiện đại thường xây dựng theo kiến trúc SPA (Single Page Application). Khi tải trang, frontend sẽ gửi một request ẩn đến một Internal JSON API để lấy dữ liệu giá cả, tồn kho và các biến thể sản phẩm.
Việc trích xuất thẳng đường link API nội bộ này và mô phỏng lại request (kèm đúng Headers và Token) giúp bạn thu về file dữ liệu JSON chuẩn hóa. Tốc độ thu thập theo cách này nhanh hơn từ 10 đến 100 lần, tỷ lệ thành công cao và tiết kiệm tới 90% lượng băng thông proxy.
Tiered Scraping và Conditional Requests
Áp dụng chiến thuật Phân tầng tần suất (Tiered Scraping) dựa trên tốc độ luân chuyển hàng hóa và mức độ biến động giá của thị trường:
- Tier 1 (Bestsellers / Flash Sale): Nhóm sản phẩm mang lại doanh thu chủ lực, thường xuyên biến động giá do cạnh tranh Buy Box. Tần suất cập nhật từ 30 đến 60 phút/lần.
- Tier 2 (Sản phẩm cạnh tranh trung bình): Các mặt hàng có sức mua đều đặn. Tần suất cập nhật 1 đến 2 lần/ngày (thường vào thời điểm bắt đầu ngày làm việc).
- Tier 3 (Long-tail / Sản phẩm ngách): Linh kiện thay thế, hàng tồn kho lưu chuyển chậm. Tần suất kiểm tra có thể giãn cách từ 3 đến 7 ngày/lần.
Đồng thời, áp dụng kỹ thuật Conditional Requests (Truy vấn có điều kiện). Khi gửi request, hệ thống đẩy kèm header If-None-Match (chứa ETag lưu từ lần thu thập trước). Nếu hệ thống chưa thay đổi nội dung trang sản phẩm, server gốc sẽ trả về mã 304 Not Modified. Kích thước gói tin lúc này gần như bằng 0, giúp hệ thống tiết kiệm dung lượng đáng kể.
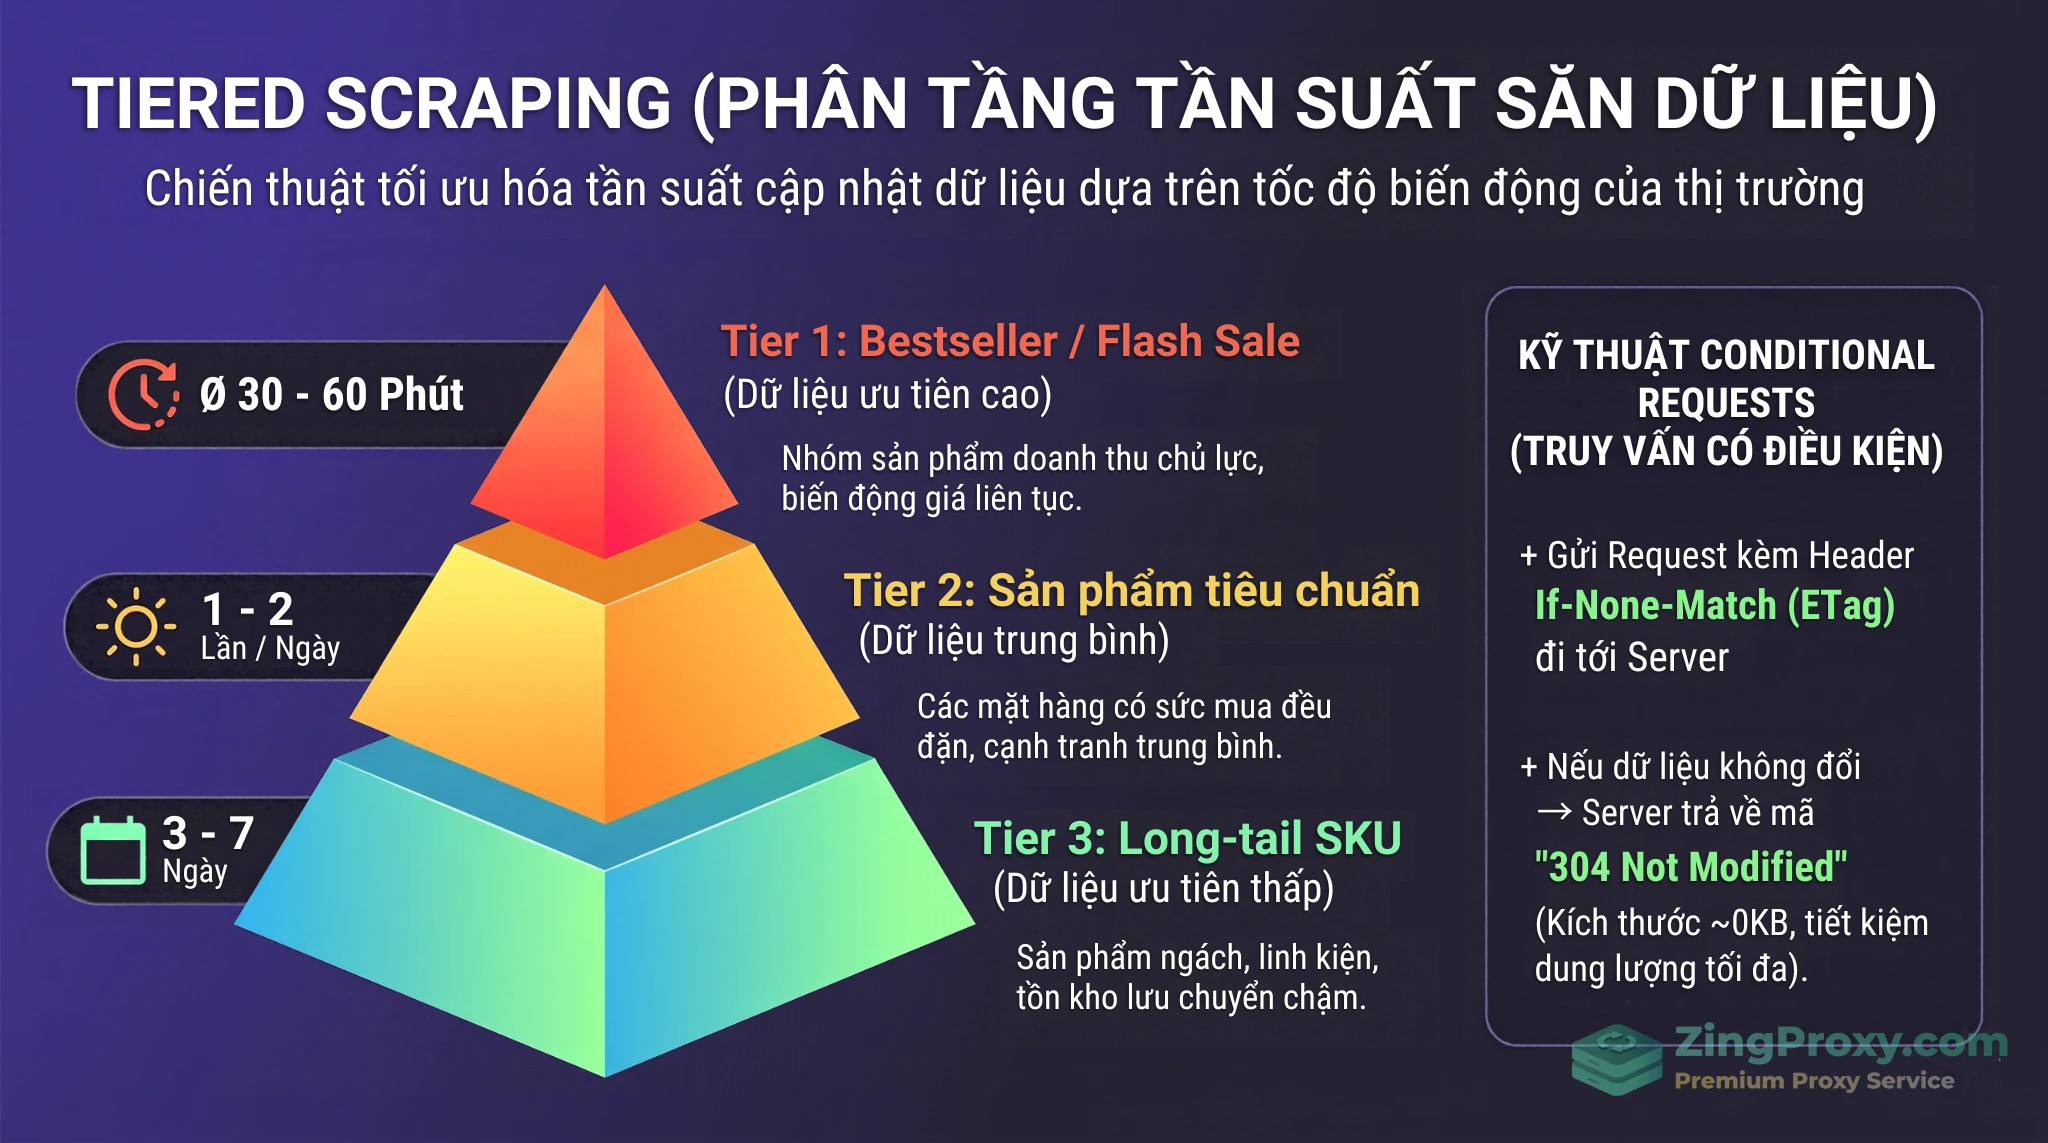
Ma trận Tiered Scraping: Phân bổ chu kỳ cập nhật dữ liệu hợp lý dựa trên mức độ biến động giá của từng nhóm sản phẩm.
Vận hành trách nhiệm và tuân thủ an toàn (Ethical Scraping)
Khi sở hữu một hệ thống thu thập dữ liệu mạnh mẽ, ranh giới giữa việc phân tích thị trường hợp pháp và vi phạm quy định bảo mật cần được thực thi nghiêm túc. Việc thiết kế crawler an toàn yêu cầu sự tuân thủ các chuẩn mực của ngành phần mềm.
- Chỉ thu thập dữ liệu công khai (Public Data): Hoạt động nghiên cứu thị trường tập trung vào các thông tin hiển thị tự do cho mọi người dùng trên Internet. Các dữ liệu này bao gồm: tên hàng hóa, mã SKU, giá bán niêm yết, thông số kỹ thuật khách quan và tình trạng tồn kho.
- Bảo vệ quyền riêng tư dữ liệu (Data Privacy): Tuân thủ các khuôn khổ pháp lý như GDPR, hệ thống trích xuất dữ liệu không được phép thu thập, nhận diện hoặc lưu trữ thông tin cá nhân (PII) của người dùng như họ tên, địa chỉ email, số điện thoại hay lịch sử mua hàng nhằm đảm bảo an toàn thông tin và tránh rủi ro pháp lý.
- Tôn trọng giới hạn hạ tầng: Luôn kiểm tra cấu hình trong file
robots.txt của website đích. Thiết lập Rate-limit nội bộ hợp lý, tránh việc gửi request với tần suất cao làm cạn kiệt tài nguyên máy chủ của nền tảng, gây ảnh hưởng đến trải nghiệm mua sắm của khách hàng thực tế.
Câu hỏi thường gặp (FAQ)
1. Proxy dân cư dùng để thu thập dữ liệu giá có hợp pháp không?
Hoạt động này hoàn toàn hợp lệ nếu bạn chỉ thu thập Dữ liệu công khai (Public Data như giá bán, tồn kho, tên SKU). Hệ thống cần đảm bảo tuân thủ các quy định bảo mật dữ liệu, không ghi nhận thông tin cá nhân (PII) và đáp ứng các giới hạn kỹ thuật trong file robots.txt.
2. Khi nào nên cấu hình Rotating IP, khi nào dùng Sticky Session?
- Rotating IP (xoay mỗi request): Dùng cho các luồng phi trạng thái (stateless) như kiểm tra hàng loạt trang danh mục, xem kết quả tìm kiếm.
- Sticky Session (giữ phiên 5 đến 30 phút): Dùng cho các luồng cần liên kết cookie (stateful) như đi qua phân trang sâu, thêm vào giỏ hàng hoặc nhập ZIP code để kiểm tra phí vận chuyển.
3. Làm sao để phát hiện hệ thống đang bị Soft Block (mã 200 OK nhưng dữ liệu sai)?
Thay vì chỉ dựa vào việc kiểm tra mã response.status_code == 200, hãy thiết lập thêm các bước kiểm tra (validation) dung lượng file HTML trả về, tìm kiếm các keyword nhận diện CAPTCHA (như Robot Check) và thường xuyên đối chiếu chéo (cross-check) một mẫu nhỏ dữ liệu với giao diện trình duyệt.
4. Tại sao thu thập dữ liệu bằng Managed APIs lại tối ưu hơn tự dựng Playwright?
Giải pháp này giúp tối ưu tài nguyên máy chủ (CPU/RAM). Thay vì phải viết code cấu hình Fingerprint, xử lý WebRTC rò rỉ hay giải CAPTCHA, bạn chỉ cần gửi một HTTP request cơ bản. Mọi cơ chế xoay proxy và định tuyến đều được hệ thống API tự động quản lý.
5. Proxy dân cư tính phí theo GB, làm cách nào để tiết kiệm chi phí băng thông?
Áp dụng đồng thời 3 kỹ thuật:
- Cấu hình chặn tải các tài nguyên không cần thiết (ảnh, video, CSS, font);
- Ưu tiên bóc tách dữ liệu từ Schema JSON-LD hoặc sử dụng Internal JSON API thay vì tải toàn trang HTML;
- Cấu hình phân tầng tần suất thu thập dữ liệu (Tiered Scraping) và dùng header
If-None-Match.
Kết luận
Việc tích hợp Proxy dân cư Dropshipping không đơn thuần là thay đổi một dãy số IP. Thực chất, đó là việc thiết lập một lớp hạ tầng định tuyến mạng chuyên biệt, giúp hệ thống crawler mô phỏng các truy cập vật lý của người dùng trên nhiều vùng lãnh thổ khác nhau.
Bằng cách kết hợp linh hoạt giữa ISP Proxies, kỹ thuật mô phỏng TLS Fingerprinting, áp dụng Managed APIs để giảm tải quản trị, và sử dụng AI (LLMs) thay cho parser truyền thống, bạn sẽ xây dựng được một pipeline nghiên cứu giá đa quốc gia hoạt động ổn định, cung cấp dữ liệu Landed Price chuẩn xác với chi phí vận hành tối ưu.
Tài liệu tham khảo